Qu’est-ce que le query fan-out ?
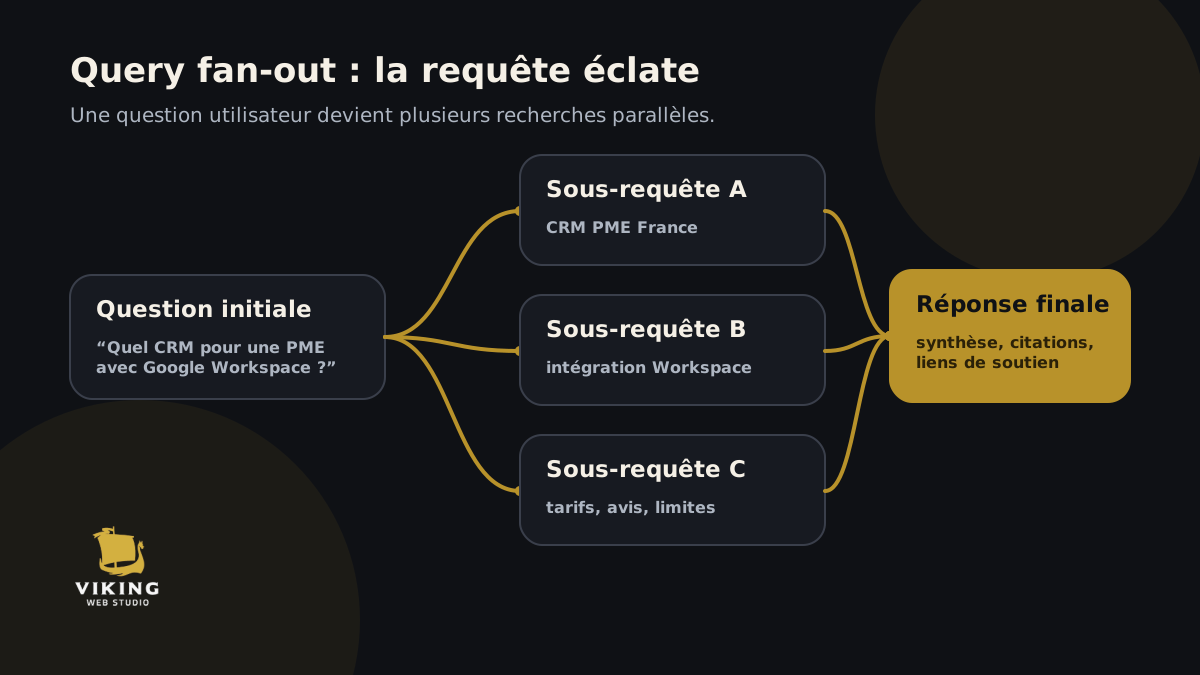
Le query fan-out est le mécanisme par lequel un moteur de recherche ou un assistant IA ne traite pas une requête comme une seule question isolée. Il la découpe en plusieurs sous-requêtes, explore différents angles du sujet, récupère plusieurs groupes de sources, puis synthétise le tout dans une réponse unique.
Dit plus simplement : l’utilisateur pose une question. Le système, lui, en entend dix. Et comme souvent en SEO, c’est là que les ennuis commencent. Enfin, les opportunités aussi, sinon je n’aurais pas écrit un article aussi long pour expliquer le principe.
Exemple : une recherche comme “quel CRM choisir pour une PME de 30 salariés qui utilise déjà Google Workspace ?” ne renvoie pas seulement vers “meilleur CRM PME”. Une IA de recherche peut aussi explorer les tarifs, les intégrations Google Workspace, les contraintes RGPD, les avis utilisateurs, les comparatifs entre solutions, la taille de l’entreprise et les besoins commerciaux. La réponse finale est une synthèse issue de ces branches.
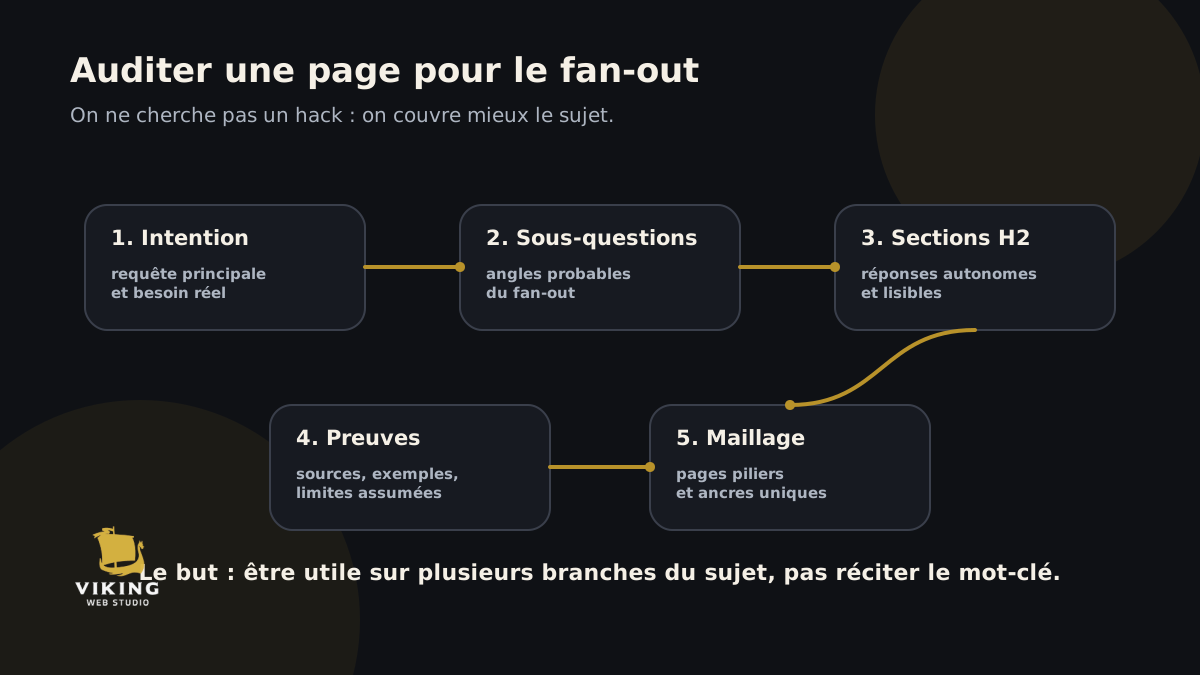
Pour le SEO et le GEO, ce changement est majeur. Une page ne doit plus seulement répondre à un mot-clé. Elle doit couvrir un territoire sémantique. Elle doit être capable d’apparaître sur plusieurs branches du sujet, y compris sur des sous-questions que l’internaute n’a jamais formulées explicitement.
Ce que Google dit réellement sur le fan-out
Google a confirmé officiellement l’usage du query fan-out dans AI Mode. Dans son article publié à l’occasion de Google I/O 2025, Google explique qu’AI Mode utilise cette technique pour découper une question en sous-thèmes et lancer plusieurs requêtes simultanément afin d’explorer le Web plus profondément qu’une recherche traditionnelle. Source : Google Search, AI Mode update.
La documentation Google Search Central en français parle de distribution ramifiée de requêtes. Elle indique que les Aperçus IA et le Mode IA peuvent utiliser cette technique pour effectuer plusieurs recherches associées sur des sous-thèmes et des sources de données, puis développer une réponse. Source : Google Search Central.
Point important : Google précise aussi qu’il n’existe pas d’optimisation spéciale, de fichier magique ou de balisage schema.org particulier pour apparaître dans les fonctionnalités IA. Les fondamentaux restent les mêmes : exploration autorisée, indexation, contenu utile, texte accessible, liens internes, expérience correcte et données structurées cohérentes avec le contenu visible.
Je le redis parce que c’est bon pour la tension artérielle des clients : je ne suis pas magicien. Et si un professionnel promet une première place garantie dans Google ou une citation certaine dans un AI Overview, il faut probablement fuir. Très vite. On ne garantit pas le résultat à 100 %. On travaille les signaux, on structure mieux, on couvre plus large, et on gagne du terrain.
Le brevet Google : utile, mais à manier avec prudence
Le brevet EP3115913B1, consacré à la recherche et à l’extraction de documents électroniques à l’aide d’un index de grande taille, permet de comprendre certains principes de récupération d’information à grande échelle. Il ne faut pas pour autant transformer chaque brevet Google en mode d’emploi exact de la SERP actuelle. Sinon nous finirions tous à lire des brevets le dimanche soir. Déjà que je publie des articles le week-end, il ne faut pas exagérer.
Ce que l’on peut retenir prudemment, c’est l’idée suivante : les systèmes de recherche modernes ne se limitent pas à “une requête = une liste de dix résultats”. Ils peuvent reformuler, classer, sélectionner, comparer et recomposer plusieurs ensembles de documents. Le query fan-out s’inscrit dans cette logique : multiplier les chemins de récupération pour produire une réponse plus complète.
| Élément observé | Ce que l’on peut dire | Ce qu’il faut éviter d’affirmer |
|---|---|---|
| Google confirme le query fan-out dans AI Mode | Le mécanisme existe officiellement dans l’écosystème Search. | Prétendre connaître toutes les sous-requêtes exactes générées. |
| Google parle de distribution ramifiée dans sa documentation | AI Overviews et AI Mode peuvent explorer plusieurs sous-thèmes. | Dire que chaque AI Overview fonctionne toujours avec le même nombre de requêtes. |
| Des brevets décrivent des systèmes de recherche complexes | Ils donnent des pistes sur les architectures possibles. | Les lire comme une documentation produit à jour et exhaustive. |
AI Mode, AI Overviews, ChatGPT, Gemini, Perplexity : même logique, pas même transparence
Le fan-out n’est pas réservé à une seule interface. Google AI Mode est le cas le plus explicite, car Google a nommé le mécanisme. Les AI Overviews peuvent aussi utiliser une distribution ramifiée de requêtes, mais l’utilisateur ne voit pas les branches générées. ChatGPT, Gemini ou Perplexity peuvent décomposer une question complexe en étapes de recherche ou en plans intermédiaires, mais leur transparence varie selon le mode, l’abonnement, l’interface et les capacités activées.
Perplexity est intéressant à observer parce qu’il affiche plus visiblement ses sources et son chemin de recherche que beaucoup d’interfaces. Des outils comme Otterly Query Fan-Out proposent aussi de simuler les requêtes potentielles issues d’un prompt. Ce ne sont pas des vérités absolues, mais de bons supports de réflexion.
| Outil | Ce qui est visible | Intérêt pour le SEO/GEO |
|---|---|---|
| Google AI Mode | Réponse IA, liens de soutien, approfondissement possible. | Comprendre la logique de recherche multi-angles dans Google. |
| Google AI Overviews | Synthèse dans la SERP, sources affichées selon les cas. | Observer les sources retenues sur les requêtes informationnelles. |
| Perplexity | Sources et chemin de recherche plus lisibles. | Repérer les types de pages et d’entités citées. |
| ChatGPT / Gemini | Décomposition souvent moins visible selon le mode utilisé. | Tester les questions, les entités, les angles et les sources attendues. |
| Outils GEO | Simulation ou suivi de prompts, citations, visibilité de marque. | Identifier les trous éditoriaux, sans prendre les résultats comme une vérité sacrée. |
Pourquoi le fan-out change le SEO
Le SEO classique part souvent d’une page, d’un mot-clé principal et d’une intention dominante. Cette logique reste utile. Mais avec le fan-out, une page peut être évaluée sur sa capacité à répondre à plusieurs sous-intentions. La visibilité se joue donc moins sur le mot-clé isolé et davantage sur la couverture du sujet.
Cela explique pourquoi certaines pages très spécialisées peuvent être citées sur une réponse IA même si elles ne ciblent pas exactement la requête principale. Elles répondent parfaitement à une branche du sujet : définition, comparaison, prix, méthode, limite technique, étude, norme, preuve, exemple métier.
Ce changement a aussi un effet sur le trafic. Seer Interactive a observé, dans une étude portant sur des requêtes informationnelles et éducatives, une baisse importante du CTR organique lorsque les AI Overviews sont présents, tout en signalant que les marques citées dans l’AI Overview performent mieux que celles qui ne le sont pas. Source : Seer Interactive. Comme toujours, il faut lire ces chiffres avec méthode : secteur, pays, période, type de requête et panel étudié comptent énormément.
Conclusion pratique : il ne suffit plus de viser “la position”. Il faut aussi devenir une source possible. Et pour devenir une source possible, une page doit être claire, découpée, vérifiable, reliée à d’autres contenus et utile sur plusieurs angles.
Cette logique éclaire aussi le rôle des AI Overviews dans la SERP française : Google ne reprend pas seulement une page pour sa requête principale, il peut extraire un passage parce qu’il répond correctement à une sous-question.
Comment optimiser un contenu pour le query fan-out
Optimiser pour le fan-out ne consiste pas à créer cinquante pages pour cinquante variantes de la même question. C’est la meilleure façon de fabriquer de la cannibalisation, puis de passer un vendredi après-midi à nettoyer le bazar dans Screaming Frog. Un bonheur rare.
La bonne méthode consiste plutôt à construire une matrice de sous-questions avant de rédiger ou de refondre la page. Pour chaque sujet, on liste les angles probables : définition, cible, problème, critères, prix, comparaison, étapes, outils, limites, erreurs fréquentes, preuves, FAQ, cas d’usage.
| Branche du fan-out | Question à couvrir | Format conseillé |
|---|---|---|
| Définition | De quoi parle-t-on exactement ? | Réponse courte + exemple. |
| Méthode | Comment faire concrètement ? | Étapes numérotées ou checklist. |
| Comparaison | Quelles options ou approches existent ? | Tableau comparatif. |
| Limites | Ce qu’on ne peut pas garantir. | Paragraphe de nuance. |
| Preuves | Quelles sources ou données soutiennent le propos ? | Liens sortants, cas, documentation. |
| Suite logique | Quelle page pilier doit être renforcée ? | Lien interne contextualisé avec ancre unique. |
Pour une stratégie GEO, cette approche rejoint directement le travail de référencement dans les réponses génératives. Une page pilier doit couvrir le service, pendant que les articles satellites expliquent les mécanismes, les méthodes et les cas concrets.
Tester le fan-out sans se raconter d’histoires
On ne peut pas voir toutes les sous-requêtes exactes générées par Google. En revanche, on peut simuler, observer et croiser les signaux. C’est moins confortable qu’un bouton “donne-moi les requêtes secrètes de Google”, mais c’est plus réaliste.
Première méthode : poser la même question dans plusieurs outils IA, puis lister les angles récurrents. Si ChatGPT, Gemini, Perplexity et un outil de simulation GEO ressortent tous les mêmes sous-thèmes, il y a de fortes chances qu’ils soient importants pour l’utilisateur.
Deuxième méthode : utiliser un crawler pour vérifier si le site aide vraiment Google à relier ces sujets. Dans Screaming Frog, lancez un crawl en Mode: Spider — en français : Mode Araignée — puis sélectionnez une page pilier. Dans la fenêtre basse, ouvrez Inlinks — Liens entrants. Pour exporter l’ensemble, utilisez Bulk Export > Links > All Inlinks — Export en masse > Liens > Tous les liens entrants. Ensuite, filtrez par URL cible et contrôlez les ancres.
Troisième méthode : regarder les SERP. Si les pages citées dans les AI Overviews couvrent toutes les mêmes sous-questions, il faut arrêter de se demander pourquoi elles sont citées. Elles ont probablement mieux répondu au fan-out que vous. Oui, ça pique. Mais au moins, ça donne une feuille de route.
Maillage interne : relier les branches sans répéter les ancres
Le fan-out pousse à couvrir plusieurs angles. Le maillage interne sert à relier ces angles entre eux. Un article technique sur le query fan-out doit pouvoir renforcer un guide sur les AI Overviews, une page service sur le GEO, un article sur le maillage interne et une ressource sur les données structurées.
Mais il faut le faire proprement. Répéter la même ancre exacte vers la même URL dans tout le contenu éditorial, c’est pratique pour écrire vite, mais mauvais pour la finesse du signal. Je préfère créer une bibliothèque d’ancres uniques par page cible. Une destination stratégique, plusieurs formulations, jamais le même copier-coller.
Par exemple, cet article peut naturellement compléter le guide méthode complète pour viser les AI Overviews, sans reprendre l’ancre déjà utilisée ailleurs. Il peut aussi renvoyer vers les fondamentaux du maillage éditorial entre SEO et GEO quand le sujet devient structurel.
Données structurées : utiles, mais pas miraculeuses
Les données structurées aident à clarifier les entités : article, auteur, organisation, fil d’Ariane, FAQ. Elles ne forcent pas une IA à citer votre page. Sinon, encore une fois, les SEO auraient tous une cape. Ou au moins une meilleure garde-robe.
Google indique qu’il n’est pas nécessaire d’ajouter un balisage spécifique pour apparaître dans les fonctionnalités IA, mais rappelle que les données structurées doivent correspondre au contenu visible. Le bon usage est donc simple : baliser ce qui existe vraiment, ne pas inventer de FAQ cachée, ne pas ajouter d’auteur fictif, ne pas promettre une fraîcheur éditoriale qui n’existe pas.
Mesurer l’impact du fan-out
Google Search Console ne fournit pas, à ce jour, un rapport magique isolant toutes les citations AI Overview ou toutes les branches de fan-out. La documentation Google indique que les sites apparaissant dans les fonctionnalités IA sont inclus dans le trafic Search Console global, dans le type de recherche Web.
Il faut donc combiner plusieurs outils : Search Console pour les impressions, les requêtes et le CTR ; Matomo pour les pages d’entrée et les conversions ; Ahrefs pour les opportunités et la concurrence ; Screaming Frog pour le maillage ; observation manuelle pour les sources citées dans les SERP.
Le bon indicateur n’est pas seulement “ai-je plus de clics ?”. C’est aussi “mon contenu devient-il une référence possible sur plusieurs branches du sujet ?”. C’est moins spectaculaire dans un reporting, mais beaucoup plus solide sur le long terme.
Méthode rapide pour reprendre une page existante
Une page orientée fan-out n’a pas besoin d’être interminable. Bon, celle-ci est un contre-exemple assez convaincant, j’en conviens. Mais elle doit être complète là où c’est utile, précise là où ça compte, et honnête sur ce qu’elle ne peut pas garantir.
Sources utiles
Questions fréquemment posées sur le query fan-out
Le query fan-out est-il une nouveauté SEO ?
Le principe de reformuler, élargir et récupérer plusieurs ensembles de documents existe depuis longtemps dans la recherche. Ce qui change, c’est sa visibilité dans les moteurs génératifs et son rôle dans des interfaces comme AI Mode ou les AI Overviews.
Peut-on connaître les sous-requêtes exactes de Google ?
Non. Google ne fournit pas la liste exacte des sous-requêtes générées pour chaque utilisateur. On peut seulement les estimer avec des outils, observer les sources citées et analyser les angles récurrents.
Faut-il créer une page pour chaque branche du fan-out ?
Pas systématiquement. Il vaut mieux créer des pages fortes, bien structurées, puis des articles satellites utiles lorsque le sujet mérite un développement autonome. Sinon, on fabrique de la cannibalisation.
Le fan-out remplace-t-il le SEO classique ?
Non. Les fondamentaux restent indispensables : crawl, indexation, structure HTML, contenu utile, maillage interne, performance, données structurées cohérentes. Le fan-out ajoute une couche de couverture sémantique.
Les données structurées aident-elles le query fan-out ?
Elles peuvent aider à clarifier les entités et le type de contenu, mais elles ne garantissent pas une citation. Elles doivent toujours correspondre au contenu réellement visible dans la page.
Comment tester une page avec Screaming Frog ?
Lancez un crawl en mode Spider, sélectionnez la page cible, puis consultez l’onglet Inlinks dans la fenêtre basse. Pour exporter, utilisez Bulk Export > Links > All Inlinks, soit Export en masse > Liens > Tous les liens entrants.
Le query fan-out concerne-t-il aussi ChatGPT et Perplexity ?
Oui, dans l’esprit. Les assistants IA peuvent décomposer une question complexe en étapes ou recherches intermédiaires, mais le niveau de transparence varie selon les outils et les modes activés.
Peut-on garantir une citation grâce au fan-out ?
Non. On peut améliorer les chances en rendant une page plus utile, plus structurée et plus crédible. On ne peut pas garantir une citation. Celui qui le promet vend une certitude qu’il ne maîtrise pas.